水文/Traditional Ecological Knowledge/原住民族治理/GIS/氣候韌性
河流不是一根水管,聖地也不是地圖上的一個點:Arhuaco 把水、森林與治理放進同一套模型
本篇從研究證據、地方知識與治理界線出發,整理河流不是一根水管,聖地也不是地圖上的一個點:Arhuaco 把水、森林與治理放進同一套模型所涉及的公共問題與台灣借鏡邊界。
山海資料庫;共同作者:馬耀|馬蘭阿美部落海洋文化作者
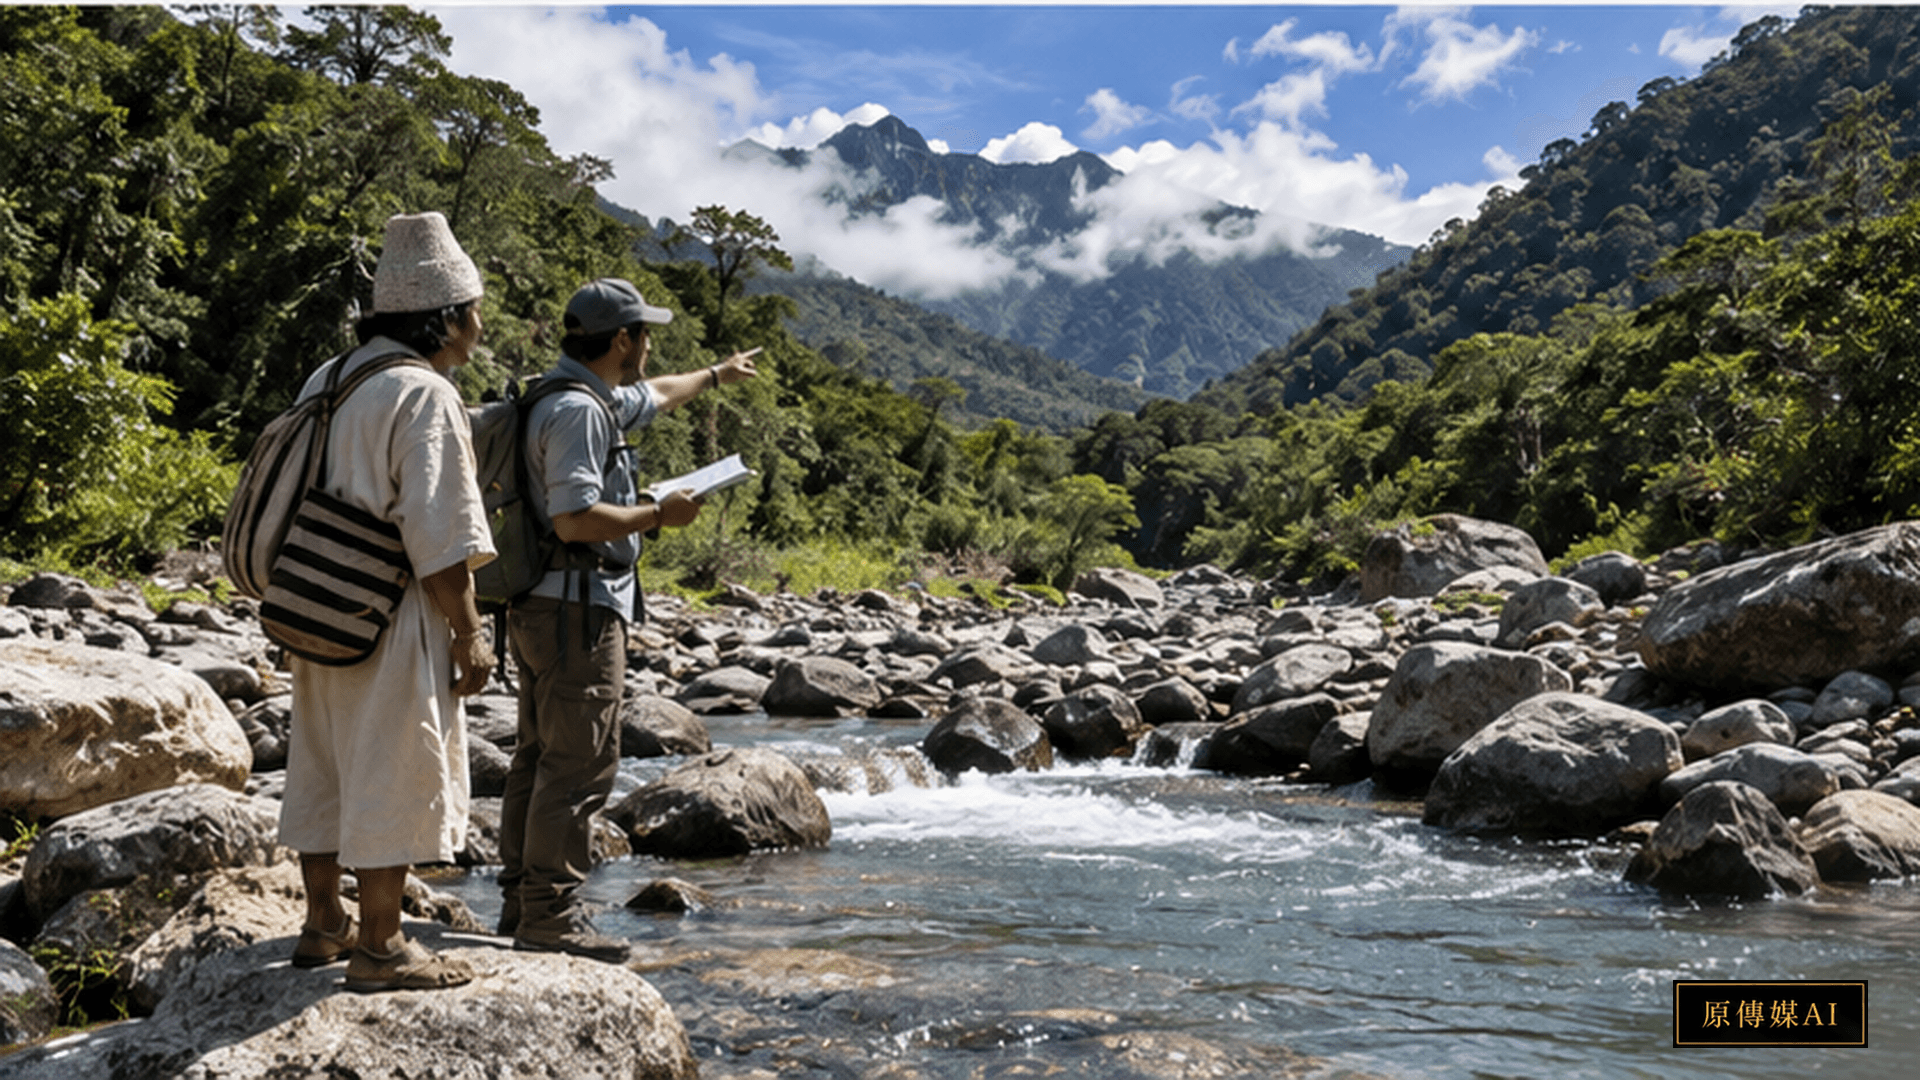
紀實編輯攝影;畫面未加入生成文字。
# 河流不是一根水管,聖地也不是地圖上的一個點:Arhuaco 把水、森林與治理放進同一套模型
作者:山海資料庫;共同作者:馬耀|馬蘭阿美部落海洋文化作者
今天這篇專題不是要把「傳統」和「科學」排成高低,而是追問:當兩套知識同時面對同一個自然世界時,彼此能不能指出對方看不見的地方?這個問題之所以重要,是因為 AI、氣候模型、GIS 與大型資料庫正在快速進入土地、文化、心理健康與公共治理;如果資料進來了,脈絡卻被刪掉,我們可能得到更快的答案,卻離真正的知識更遠。
第1章|如果河流是關係,不只是流量,研究怎麼量?
本章先把研究證據與文化敘事分開。最重要的是:《Human Ecology》於 2026 年 9 月 17 日刊出 Upper Ariguaní River basin 的 Arhuaco 水治理研究。研究包含 48 份社群調查、5 次半結構訪談、2 組 Mamʉ focus groups、2 場共 32 人 participatory workshops,並整合 2000–2023 land-use change 與 dynamic socio-hydrological modelling。樣本由傳統權威協助選定,是 purposive sample,不是統計代表樣本。。這些材料讓我們看見,研究問題本身會因為地方知識加入而改變。自然科學擅長把現象轉成可比較的數值、模型與不確定性;原住民族與地方知識則常把時間、地點、關係、責任與生活後果一起保留下來。兩者並置時,不需要誰替誰背書,而是要問:哪一種尺度被另一種方法漏掉了?
從編輯角度看,第一個防呆就是不要把研究論文、博物館/政府的文化資源、社群敘事與本文分析混成同一種證據。每一個具體數字、研究方法或制度描述都必須能回到來源;文化意義則應清楚標示來源脈絡。這樣讀者才能知道哪些是研究結果,哪些是文化說明,哪些是原傳媒AI的跨領域分析。
第2章|48份調查加一張20多年土地變遷圖
知識不是離開現場後仍完全不變的物件。誰觀察、何時觀察、為什麼需要這項判斷、錯誤會造成什麼後果,都可能是知識的一部分。如果研究只留下可以塞進資料表的欄位,資料會變整齊,但意義可能變薄。雙向知識真正困難的地方,是既要讓資料能被比較,又不能把文化脈絡、社群權利與使用界線刪掉。
如果未來把這些內容放進傳統知識聊天機器人,資料欄位至少要能回答:這項知識屬於誰?在哪裡成立?何時成立?誰記錄?可否公開?可否訓練模型?是否有版本差異?誰能修正?若系統只保存名詞與定義,AI 很容易把局部知識說成普遍真理。
第3章|Sacred sites 不是點位,而是治理節點
當模型、統計或制度分類與地方觀察不一致時,不一致本身就是高價值資料。研究者應檢查空間解析度、時間尺度、變數缺漏、樣本選擇與研究目的;社群觀察也有自己的適用範圍,不能任意外推。成熟的合作不是追求『大家得到同一答案』,而是建立一套可以保存差異、回到現場、再驗證的流程。
這也是 Two-Eyed Seeing 最容易被誤解的地方。它不是把兩套知識平均混合,也不是要求雙方永遠同意;更重要的是讓不同證據方式都有位置,並建立可以互相校正而不互相吞沒的研究設計。當差異被保留下來,新的研究問題才會出現。
第4章|為什麼傳統知識單獨也撐不住土地快速改變?
本章特別處理不能超譯的地方:TEK Index 是研究者建構的分析指標,不是文化知識考試。模型是 scenario tool,不是未來預言;sacred sites 不能被寫成神祕能量點。Arhuaco 的 ontology、Mamʉ 制度與領域治理不可直接套到台灣。。這些限制不是削弱文章,而是保護可信度。生成式 AI 很容易把不完整證據補成流暢故事;在原住民族知識領域,流暢不等於正確。來源沒有支持的儀式、禁忌、身份、名稱或因果關係,系統應保留未知,而不是依相似文化自動補完。
媒體敘事也需要同樣的節制。吸睛標題可以提出張力,但正文必須把因果、相關、模型情境、參與式研究與文化敘事分清楚。若一篇文章把『可能』改寫成『一定』、把『特定案例』改寫成『所有原住民族』,再漂亮的故事都會變成新的誤導。
第5章|回到台灣:可以學 participatory mapping,不能複製 Arhuaco 世界觀
回到台灣時,最值得移植的是方法而不是答案。可以從社群真正關心的問題開始,共同定義要記錄什麼,再決定感測器、GIS、RAG、知識圖譜或多媒體工具如何加入。資料必須保留來源、時間、地點尺度、權限、版本與不確定性,也要讓社群有修訂與拒絕公開的能力。這樣科技才是支援地方決策的工具,而不是要求地方經驗配合科技格式。
對教育而言,可以讓學生把『科學模型使用的變數』與『地方知識持有人實際關心的訊號』列成兩欄,再討論哪些內容能量化、哪些需要敘事、哪些涉及權限。這比背誦傳統知識名詞更接近真正的雙向知識,也更適合未來 AI 素養教育。
原傳媒AI編輯觀察
這個題目真正值得留下的,不是一句「古老智慧值得保存」,而是一套更嚴格的知識工程觀:科技必須知道自己看不見什麼。模型可以提供廣域比較與推演,地方知識可以指出生活尺度、文化責任與長期變化;兩者都需要說清楚適用範圍與限制。
若未來進一步做 RAG、多模態辨識、語音轉譯或知識圖譜,最重要的不是把資料量做大,而是把 provenance、permission、place、time、community authority、version 與 uncertainty 做進架構。真正成熟的 AI,不是每一題都回答,而是知道何時應該查證、何時應該讓社群自己說、何時必須回答「目前不知道」。
不可超譯
TEK Index 是研究者建構的分析指標,不是文化知識考試。模型是 scenario tool,不是未來預言;sacred sites 不能被寫成神祕能量點。Arhuaco 的 ontology、Mamʉ 制度與領域治理不可直接套到台灣。
主要來源
- Human Ecology research article
- Colombia national parks biocultural restoration notice
- Tayrona 2026 temporary closure notice
方法補充|如何把這篇文章變成可追溯的數位知識
建議每一項研究事實建立 source_id,每一段文化說明建立 community/context 欄位,每一項編輯推論標記 analysis。若來源更新,保留舊版本與日期,不直接覆蓋。對敏感文化內容則設定 access level,讓公開版、研究版與社群內部版可以不同。這種做法雖然比單純建立全文向量庫麻煩,卻能大幅降低 AI 把脈絡錯置、跨族群套用或生成虛構細節的風險。
讀者如何讀這份證據
讀者應把這項研究中的水文模型、訪談、focus groups、participatory workshops 與 Arhuaco 的治理脈絡分別閱讀。模型可以協助比較 land-use change 的情境,卻不會自動替社群決定 sacred sites 的意義,也不能把 TEK Index 當成衡量文化真實性的分數。研究樣本由傳統權威協助選定,這是治理安排的一部分,同時也提醒我們不能把它誤讀成統計代表。
若台灣地方想借鏡 participatory mapping,應先問誰能代表領域、哪些地點不宜公開、資料由誰保管、模型錯誤時誰能要求修正。流域治理不只是畫出水線,還包含責任、季節、禁限與長期維護;任何工具都應服從地方可撤回的決定。
因此,跨地移植的最低條件是共同定義問題、保留地方語言與關係、公開模型限制,並讓社群在結果發布前有實質審閱權。這些程序不是研究附錄,而是研究能否成立的一部分。
最後,任何延伸應用都要保留原始來源、審閱日期、資料權限與修訂紀錄,讓受影響的人能看見、補充、反對或要求停止使用。公開版本也應清楚標示哪些是已知事實、哪些是情境推演、哪些仍待地方共同確認,避免後續轉載時失去證據邊界。
角色驅動追問
原傳媒AI|依你的角色繼續追問
先選擇角色,再閱讀該角色可能提出的完整問題;點選後,原傳媒AI 會以逐字顯示方式呈現完整回覆。
先選擇角色
部落領域/水治理知識工作者
從部落領域/水治理知識工作者的證據需求、權利關係與實務責任出發,辨識研究能回答什麼、不能回答什麼。
再選擇問題
AI 使用與內容安全揭露
本文由作者審查後發布;AI 協助整理公開來源與格式轉換,研究證據、文化脈絡與編輯分析分別標示。
Newsletter
喜歡這篇文章?
訂閱原傳媒AI電子報,每日接收AI、傳統知識與雙向知識更新。