AI/資料主權/文化安全/數位治理/族語教育
AI 可以學我們的語言,但誰准它記住我們的知識?First Nations 把 AI 教育轉向資料主權
第一民族科技委員會發布最新人工智慧學習資源,將數位素養核心推進至資料主權與文化安全。本文解析四層式 RAG 架構、邊緣語音模型與原住民族集體授權防線。
鍾靜蓉|台科大數位教育博士
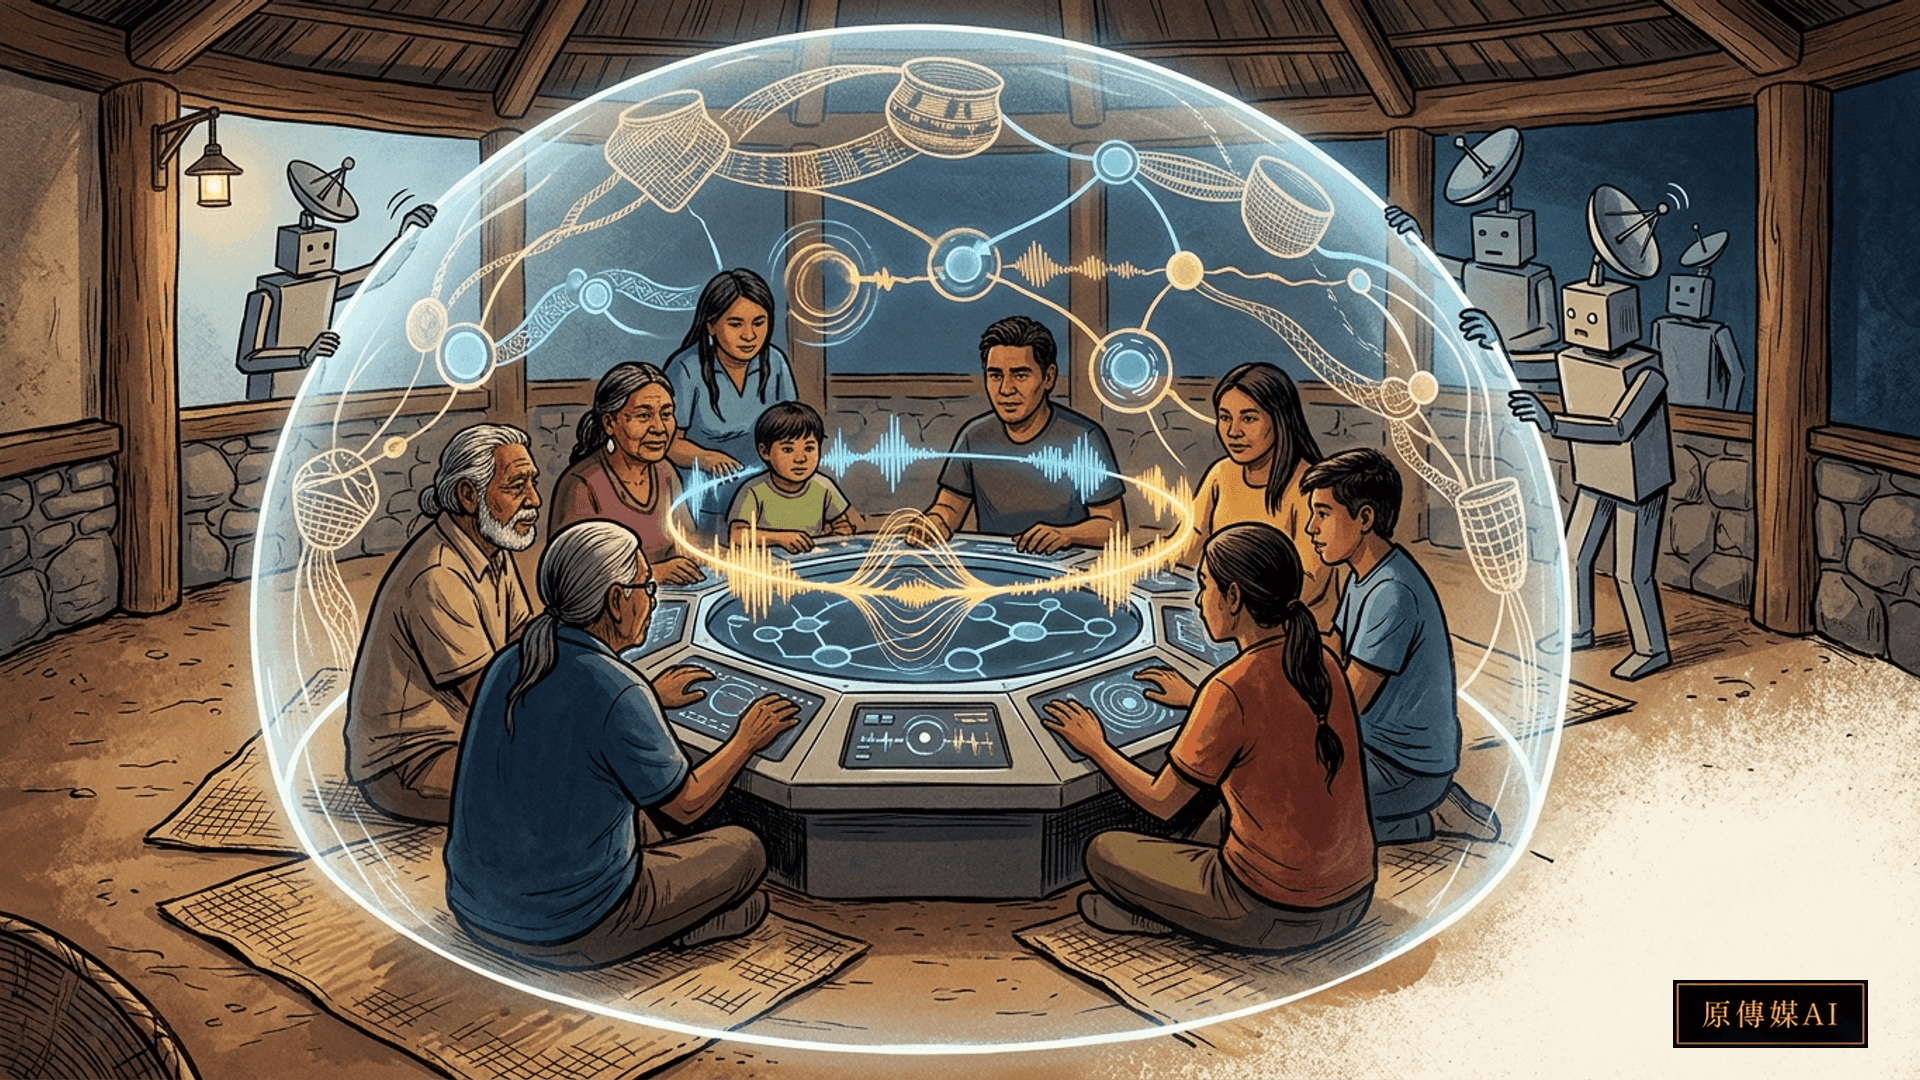
AI 生成概念插畫,非研究現場照片。
超越工具操作:人工智慧素養的根本重構
當生成式人工智慧以驚人速度滲透至基礎教育、公共服務、影音創作與行政決策體系時,多數科技教育推廣方案依然停留在工具操作層面:教導使用者如何撰寫提示詞、如何利用自動化工具生成投影片,或是如何呼叫大語言模型翻譯不同語種。然而,對於長期承受文化被挪用與資料被無償抽取的原住民族社群而言,科技素養的第一課從來不是「如何更熟練地召喚人工智慧」,而是「這套演算法依據誰的資料建造、代表誰的價值觀,以及誰賦予它記憶祖傳知識的權利?」
2026年9月17日,位於加拿大卑詩省的第一民族科技委員會(FNTC)正式發布全新的人工智慧學習資源套件,延續其發起的「第一民族人工智慧進路」(First Nations Approaches to AI)跨部落對話。這項教育專案毫不保留地將隱私保護、資料治理、文化安全、演算法偏見、歷史準確性與社群控制權置於核心地位。這項倡議宣告了人工智慧教育的重大範式移轉:原住民族社群拒絕淪為被動接受商業演算法的消費者,而必須成長為能夠自主審查、監督並定義科技邊界的資料治理決策者。
這場反思的急迫性,來自全球科技巨頭對公共網際網路內容無休止的爬取與清洗。商業大模型透過海量文本的機率統計建立關聯,卻完全抹去了知識生成時的倫理責任與生命脈絡。在西方智慧財產權與公有領域(Public Domain)法理的掩護下,原住民族被錄音的長老訪談、被掃描的古老神話、被記載的儀式禁忌,皆被科技企業視為免費無償的模型訓練素材。當這些資料被熔煉進數千億個參數的神經網絡後,演算法便能以廉價且輕浮的方式,隨時回應任何外部使用者的隨機探詢,進而掏空了知識背後神聖的文化責任。
脈絡與關係的瓦解:「看得到」不等於「自由授權」
傳統知識與現代資訊最根本的分水嶺,在於知識是否具有不可分割的「關係性」與「情境性」。在原住民族的宇宙觀中,知識並非漂浮於虛空中的客觀代碼,而是與特定的土地、祖靈、家族世系及神聖時節緊密共生的生命實踐。一段古老的獵場傳說,依循習俗或許僅能在冬季嚴寒圍爐時由特定宗族長老講述;一首神聖的祭儀吟唱,唯有具備特定祭司身分或歷經嚴格成年禮者方能聆聽學習;而關於特定高山藥用植物的採集與炮製祕傳,更承載著不得任意向外人洩漏的氏族誓約。
然而,當這些承載著繁複責任的文化資產被數位化轉錄為純文字檔案,並輸入無差別訓練的大型語言模型時,所有神聖脈絡與使用禁忌瞬間蕩然無存。演算法不具備敬畏之心,無法辨識發言者的社會身分,更不可能遵守季節性的文化節奏。任何一名坐在千里之外的網際網路使用者,只要輸入一句輕率的提示詞,模型便會毫不猶豫地將被解構的傳統知識拼貼成看似流暢的回答。
更令人憂慮的是「集體同意」在傳統著作權法中的制度性失語。現行的個資法規與數位平台授權條款,清一色建立在個人主義的知情同意勾選框架之上。然而,在原住民族社會中,任何個人即使作為口述者,亦無權單方面將屬於整個氏族、部落甚至民族共有共享的傳統智慧,無條件轉讓予跨國科技公司作為商業獲利用途。全球原住民族資料聯盟制定的 CARE 原則(集體利益、控制權威、倫理責任與互惠原則),以及加拿大原住民族廣泛採納的 OCAP 原則(擁有權、控制權、存取權與保管權),正是對這種個人主義掠奪機制的強力反制:資料治理不能只是一紙勾選的點擊協議,而必須是具備集體監督與撤回機制的實質制度。
檢索增強生成架構下的四層式權限防線
面對生成式人工智慧的應用誘惑,原住民族並非採取全面封閉的鴕鳥心態,而是積極尋求在技術架構層面落實資料主權的具體工程解方。相較於將私有資料直接灌注於無法撤回的底層大模型參數中進行微調,檢索增強生成(RAG)架構因其具備外部資料庫分離、可即時更新與可精準設定存取控制的特質,被視為落實原住民族資料治理的關鍵途徑。
然而,標準的商業 RAG 系統通常僅具備粗糙的使用者帳號權限劃分,無法應對原住民族文化資產的細緻倫理分級。為此,先進的數位治理工程提出了「四層式語意檢索資料庫架構」:
第一層為「公共開放層」,包含經社群完全審核公開的基礎語言教材、已發表的學術歷史文獻及政府法定公開資訊,允許公眾自由查詢;
第二層為「教育推廣層」,包含適合在各級學校與部落課堂中進行文化教育的故事、歷史脈絡與生活辭彙,需經由註冊教育機構或部落教師帳號授權存取;
第三層為「社群治理層」,涵蓋部落議會決策紀錄、傳統領域邊界調查、氏族系譜與特定家族生產技藝,僅開放予具備該族群成員認證或部落簽約的研究人員查閱;
第四層則為「神聖敏感層」,涉及祭祀密儀細節、神聖起源聖地、高敏感採集點與瀕死長老特定交代之口述。此層級的原始文字與影音檔案絕對禁止載入任何自動檢索向量庫,僅在系統中保留後設詮釋資料索引與聯絡管道。當外部使用者探詢相關核心問題時,人工智慧系統將明確回覆:「本項知識屬特定家族/部落專屬神聖範疇,系統不提供自動生成回答,請依部落禮俗向文化委員會或指定長老正式請益。」
這種技術架構的重大意義,在於讓科技系統學會「有尊嚴地保持沉默」。在傳統知識領域,一個看似文采斐然卻充斥幻想與扭曲的「幻覺答案」,其破壞力遠甚於一片誠實的空白。人工智慧唯有被賦予嚴格的邊界感與知止的能力,才可能從潛在的文化威脅轉化為捍衛知識體系的數位衛兵。
本地邊緣運算與語音資料的生物特徵防護
除了純文字檢索之外,族語自動語音辨識(ASR)與語音合成技術的爆發,更將資料主權的戰線推向了人體生物特徵的深水區。語音錄音絕非單純的聲學波形與音素符號,它銘刻著講話長者的獨特聲紋、呼吸節奏、家族腔調、年齡階級與飽滿的情感記憶。在原住民族文化中,聲音本身即承載著靈魂與權威。
若將珍貴的部落長老族語錄音未經加密直接上傳至公有雲端平台進行模型轉錄,無異於將族人的聲音生物特徵與文化密碼完整奉送給外部數據商。外部惡意實體極可能利用少數錄音樣本進行高保真度的語音複製,在未經授權的商業廣告、虛擬偶像甚至偽造言論中盜用長老長輩的聲音。因此,第一民族科技委員會在技術指引中強烈呼籲:原住民族語音科技的研發必須全力轉向「本地邊緣運算」與「私有雲端伺服器」。
藉由在部落社區活動中心或文化館建立自主控制的小型高效能運算節點,訓練輕量化的開源語音辨識模型,所有原始錄音檔案從採集、標註、訓練到推論,皆在部落內部的局域網絡中完成,全程杜絕外部公有雲的遙測收集與外流風險。這種看似繁複的在地技術架構,並非技術發展的倒退,而是捍衛社群文化安全不可退讓的底線。
台灣原住民族語數位典藏與主權治理的挑戰
將視野拉回台灣,這場國際原住民族數位主權運動對本地政策具有震撼性的啟示意義。自台灣推動原住民族語言發展法以來,原住民族委員會、原住民族語言研究發展基金會以及各大專院校,投入龐大資源建立了規模可觀的族語語料庫、口述歷史數位典藏與文化地圖資料庫。然而,在當前產官學界爭相擁抱「主權人工智慧」的大浪潮下,台灣社會對於「原住民族資料主權」的制度性反思依然顯得極為薄弱。
許多專案計畫在蒐集部落耆老口述歷史時,仍沿用過時的著作權轉讓同意書,將族人的智慧財產無條件歸屬於委託機關或學校團隊;部分科技團隊更未經部落自主審議,便逕自將國家語料庫的公共釋出版本作為訓練商業語言模型與多模態應用的燃料。這種只看重「數位保存成效」卻忽略「在地主權控制」的做法,極易讓原本旨在振興族語的美意,淪為新一輪的文化資料收割。
台灣亟需借鏡第一民族科技委員會的行動綱領,推動原住民族數位治理的法制革新:首先,在政府補助之族語大模型與智慧學習專案中,強制導入 CARE 原則與 OCAP 原則的倫理審查門檻;其次,協助部落建立具備自決權能的「數位資料管理委員會」,賦予部落就其文化典藏具有最終存取授權、用途限制與撤回權;最後,在體制內推廣以原住民族主體性為核心的科技倫理素養教育,培養具備演算法批判能力與部落責任感的新一代原民數位青年。
自主造橋:科技必須服務於人的尊嚴與自治
科技工具本身從不中立,它所映照與放大的,正是其背後制度架構的權力關係。人工智慧究竟是成為壓迫原住民族、加速文化同化的數位推土機,還是轉化為賦能部落、強化語言生命力與社群自治的堅固盾牌,完全取決於掌控系統開關與規則制定權的人是誰。
真正的原住民族科技賦權,不在於部落課堂上配發了多少台平板電腦,也不在於介面選單中新增了多少個族語標籤,而在於社群是否擁有堅定的否決權與決定權。當原住民族有權決定哪些記憶能夠被演算法學習、哪些神聖智慧永遠不得被機器記錄時,人工智慧才可能走出資料殖民的歷史泥淖,真正走向平等、尊重與文化多元共存的新紀元。
資料來源與延伸閱讀
角色驅動追問
原傳媒AI|依你的角色繼續追問
先選擇角色,再閱讀該角色可能提出的完整問題;點選後,原傳媒AI 會以逐字顯示方式呈現完整回覆。
先選擇角色
人工智慧系統架構與工程研究員
從人工智慧系統架構與工程研究員的責任、證據需求與實務風險出發,辨識研究能回答什麼、不能回答什麼。
再選擇問題
AI 使用與內容安全揭露
本文與問答由 AI 協助整理公開來源及撰寫;來源支持的事實、編輯解讀與台灣情境分別說明。
Newsletter
喜歡這篇文章?
訂閱原傳媒AI電子報,每日接收AI、傳統知識與雙向知識更新。